
첫 금융권 프로젝트에 대한 회고
Jenkins CI/CD 업무를 처음 받았을 때만 해도 단순히 Groovy 스크립트를 작성하는 일이라고 생각했다. 꽤나 편안한 5개월이 될 줄 알았다.
역시나 인생에 쉬운 건 없었고, 조상의 얼과 혼이 담긴 듯한 숙성된 파이프라인 코드를 마주하자 생각이 많아졌다.
이번 프로젝트는 은행권 모바일 웹뱅킹 재구축에 맞춰 기존 CI/CD 인프라를 확장하고 개선하는 작업이었다.
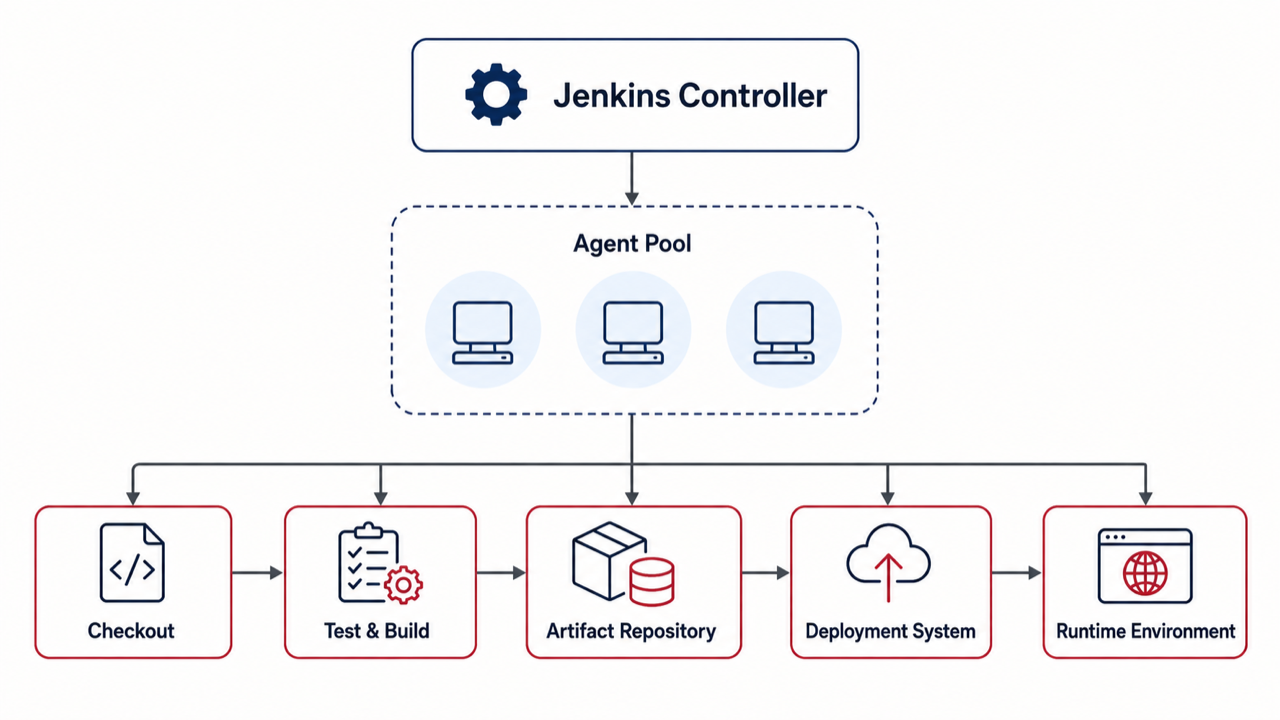
기존 2대의 CI/CD 서버에 신규 서버 1대를 추가하고, 프론트엔드(프로젝트) 16개, 백엔드(backend) 8개, 컨테이너 플랫폼(PaaS) 4개로 구성된 총 28개 애플리케이션의 빌드 및 배포 환경을 구성해야 했다.
GitLab, Nexus, Quay Registry, ArgoCD를 연계하고, 테스트계와 운영계에서는 기존 형상·배포 관리 시스템인 PCMS의 요청을 받아 파이프라인이 실행되도록 구성하는 것이 주요 작업이었다.
몇몇 생소한 이름을 제외하면 기술 스택 자체는 익숙한 조합이었다.
문제는 이미 운영 중인 환경이라는 점이었다. 여러 시스템이 CI/CD 인프라를 공유하고 있었고, 기존 파이프라인에는 오랜 시간 쌓인 환경 의존성과 배포 절차가 녹아 있었다.
자연스럽게 의문이 생겼다.
‘하하… 이 사람은 이걸 의도 한걸까? 아니면 어쩔 수 없이 이렇게 짠 걸까?’
단순히 스크립트의 동작을 이해하는 것만으로는 부족했다. 기존 코드가 왜 그런 구조로 작성되었는지, 변경했을 때 다른 시스템에 영향을 주지는 않을지까지 살펴봐야 했다.
운영 중인 CI/CD를 확장한다는 건 새로운 파이프라인을 추가하는 일이면서, 동시에 기존 시스템이 유지해 온 실행 순서와 환경 의존성, 배포 절차를 이해하는 일이기도 했다.
대 AI 시대에 폐쇄망이란. 갑자기 머리가 아팠다
1. LEVEL 1 > 개발계
예상보다 길었던 코드 분석 시간이 지나고 드디어 개발계 파이프라인을 작성할 차례가 왔다.
사실 파이프라인이라는 게 직접 돌려보기 전에 동작을 완벽하게 예측한다는 건 내 지능으로는 꽤 어려운 일이다.
처음에는 작업할 컴퓨터조차 없었지만, 운 좋게도 좋은 담당자를 만나 자리를 마련해 주신 덕분에 본격적으로 코드를 작성할 수 있었다.
(당연한 일이라고 생각할 수 있지만, 세상에는 당연하지 않은 일이 꽤 많다.)
첫 번째 허들, Jenkins보다 까다로웠던 빌드 환경
개발계에서 가장 먼저 마주한 허들은 Jenkins나 Groovy 문법이 아니었다. 애플리케이션을 빌드하기 위한 실행 환경이었다.
기존 파이프라인을 참고해 Checkout부터 Build까지 순서대로 구성했다.
그리고 예상대로 콘솔 출력은 빨간색이었다. 역시 한 번에 돌아갈 리 없었다.
백엔드는 Java 21을 요구했지만 Jenkins Agent에는 Java 17이 설치되어 있었고, Gradle 버전도 맞지 않았다.
프론트엔드는 폐쇄망 Nexus에서 일부 패키지를 찾지 못하거나 pnpm lockfile과 의존성 정보가 일치하지 않아 설치 단계부터 실패하는 경우가 있었다.
지금이야 로그를 보면 어떤 문제인지 어느 정도 짐작할 수 있지만, 당시에는 성격이 다른 오류들이 여기저기서 발생했다.
Java 버전을 맞추면 Gradle에서 문제가 생기고, 의존성을 해결하면 다른 애플리케이션에서 오류가 발생했다. 하나를 해결했다고 생각하면 또 다른 문제가 기다리고 있었다.
돌이켜 보면 개별 오류를 해결하는 것보다 여러 문제를 구분하고 추적하는 일 자체가 더 큰 허들이었던 것 같다.
분명 빌드 명령어에는 문제가 없는데 빌드가 안 된다.
문제를 하나씩 해결하다 보니 파이프라인 코드를 작성하는 시간보다 서버 환경을 들여다보는 시간이 더 길어졌다.
Java와 Gradle의 실행 경로를 확인하고, Nexus 설정과 의존성을 비교했다. 빌드 도구가 요구하는 시스템 라이브러리까지 확인해야 했다.
빌드가 안 되는 이유가 코드에만 있는 건 아니었다
백엔드의 Java와 Gradle 문제를 어느 정도 해결하고 나니 이번에는 프론트엔드에서 문제가 발생했다.
Node.js 버전도 맞췄고, pnpm 의존성 설치도 어느 정도 해결했으니 이제는 빌드가 될 거라고 생각했다.
하지만 Next.js 빌드 과정에서 또 다른 오류가 발생했다.
이번에는 GLIBC_2.29 not found였다.
솔직히 JavaScript 애플리케이션을 빌드하는데 리눅스의 시스템 라이브러리까지 확인하게 될 줄은 몰랐다.
로그를 확인해 보니 Next.js에서 사용하는 SWC 네이티브 바이너리를 로드하는 과정에서 서버의 glibc가 필요한 버전을 제공하지 못하고 있었다.
Node.js와 패키지 버전을 맞춘 뒤에도 빌드 도구가 의존하는 운영체제와 시스템 라이브러리의 호환성을 확인해야 했다.
SWC의 WASM 사용이나 Webpack 기반 빌드로 우회하는 방법을 살펴봤고, 당시에는 Webpack으로 빌드 경로를 변경해 실제 빌드를 진행했다.
특정 서버에서 발생하는 문제를 빌드 설정으로 우회하고 나니 한편으로는 찜찜했다. Agent의 시스템 라이브러리 호환성 문제는 여전히 남아 있었다.
그렇다고 서버의 glibc를 무작정 변경할 수도 없었다. 이미 실행 중인 다른 애플리케이션과 빌드 도구에 미치는 영향까지 확인해야 했고, 주어진 일정 안에 환경 변경과 검증을 마치기는 어려웠다.
결국 당시 환경에서 동작하는 빌드 설정을 적용하고, 서버 환경의 호환성은 이후에도 해결해야 할 과제로 남겼다.
프론트엔드 빌드를 하러 왔다가 리눅스 환경을 공부하고 있었다.
이 경험을 겪고 나니 서버마다 빌드 결과가 달랐던 일도 다시 보였다.
기존 서버에서는 정상적으로 실행되던 작업이 신규 서버에서는 실패하는 경우가 있었다.
동일한 파이프라인을 실행하는데 어느 Agent에서 빌드하느냐에 따라 결과가 달라지는 것이다.
CI/CD는 빌드와 배포 과정을 자동화하기 위한 시스템이다. 그런데 정작 빌드 결과가 서버의 환경에 따라 달라지고 있었다.
처음에는 각각의 빌드 오류를 해결하는 데 집중했지만, 작업을 진행하면서 문제를 조금 다르게 보게 됐다.
이건 단순히 Java 버전이 맞지 않거나 특정 패키지를 찾지 못하는 문제가 아니었다. 빌드 환경을 어떤 방식으로 관리하고 일치시킬 것인가에 대한 문제에 가까웠다.
Jenkins Pipeline을 코드로 관리한다고 해서 빌드 환경까지 재현할 수 있는 건 아니었다.
파이프라인에 정의된 실행 순서가 같더라도 서버에 설치된 런타임과 빌드 도구, 내부 저장소 설정이 다르면 같은 결과를 기대하기 어렵다.
결국 파이프라인 코드뿐 아니라 그 코드를 실행하는 환경도 함께 관리해야 한다는 것을 알게 됐다.
물론 이번 프로젝트에서 기존 구조를 전부 바꿀 수는 없었다.
이미 운영 중인 환경이었고, 다른 시스템에 미칠 영향도 고려해야 했다. 우선은 기존 구조를 유지하면서 빌드에 필요한 환경을 맞추고, 발생하는 문제를 하나씩 해결하는 방향으로 진행했다.
환경 분석한 문서 좀 공유해주지..
적어도 오류를 보고 나서야 Java 버전을 확인하는 일은 줄일 수 있을 텐데
LEVEL 2 > 테스트계
두 번째 허들, Job을 합치는 게 전부는 아니었다
개발계에서 어느 정도 빌드가 돌아가기 시작하자 테스트계 작업이 기다리고 있었다.
개발계가 개별 애플리케이션을 빌드하고 배포하는 환경이었다면, 테스트계는 여러 업무를 하나의 요청으로 받아 처리해야 하는 환경이었다.
기존 파이프라인에는 업무별 Job이 있었고, 여기에 여러 업무를 한 번에 처리하는 통합 Job을 추가해야 했다.
처음에는 크게 어렵지 않을 거라고 생각했다.
상위 Job에서 파라미터를 받아 하위 Job을 호출하고, 결과를 취합하면 되는 것 아닌가.
물론 생각은 늘 간단하다.
개발계에서는 개발자가 특정 업무를 선택해 직접 빌드할 수 있었지만, 테스트계는 PCMS에서 전달한 배포 요청을 기준으로 동작해야 했다.
PCMS에서 요청한 업무 목록을 분석하고, 애플리케이션 유형에 따라 필요한 하위 Job을 실행한 다음 결과를 다시 PCMS에 전달해야 했다.
겉으로는 모두 Jenkins Job이지만 하는 일은 조금씩 달랐다.
이 과정에서 고민했던 부분은 기존 파이프라인을 어디까지 재사용할 것인가였다.
모든 환경을 하나의 파이프라인으로 통합하면 코드 중복은 줄어든다. 대신 개발계인지 테스트계인지, PCMS 요청인지 GitLab 기준 빌드인지 구분하는 조건문이 늘어난다.
반대로 환경마다 코드를 복사하면 당장은 편하지만 이후 수정할 때마다 여러 곳을 고쳐야 한다.
결국 기존 Shared Library를 유지하면서 모바일 웹뱅킹 전용 Job과 환경별 설정을 분리하는 방향으로 진행했다.
기존 프로젝트 파이프라인도 같은 인프라를 사용하고 있었기 때문에 공통 라이브러리를 대규모로 수정하는 건 부담스러웠다.
아무리 좋은 리팩터링이라도 이미 운영 중인 시스템에서는 이야기가 달라진다.
내가 수정한 코드 한 줄이 어디까지 영향을 미칠지 모른다면, 그 한 줄을 수정하는 데에도 생각보다 많은 확인이 필요하다.
이번 프로젝트에서는 코드를 얼마나 예쁘게 공통화했는지보다 변경의 영향 범위를 어디까지 제한할 수 있는지가 더 중요한 기준이었다.
PCMS와 Jenkins, 생각보다 복잡했던 관계
테스트계에서는 PCMS와 Jenkins의 연동도 중요한 부분이었다.
개발계에서는 GitLab의 개발 브랜치를 기준으로 소스를 가져오지만, 테스트계와 운영계에서는 PCMS가 관리하는 형상을 사용했다.
테스트계에서는 검증을 위해 GitLab 소스를 직접 Checkout해야 하는 경우도 있었다.
이를 구분하기 위해 배포 아이디를 기준으로 PCMS 형상과 GitLab 소스 사용 여부를 판단하도록 구성했다.
처음에는 단순히 Checkout 경로를 분기하는 문제라고 생각했다.
하지만 작업을 진행하다 보니 어느 소스를 가져오는지보다 그 소스가 어떤 배포 요청에 속해 있는지가 더 중요했다.
Jenkins에서는 정상적으로 빌드에 성공했더라도 PCMS에서 관리하는 형상과 다르다면 정상적인 배포 결과라고 보기 어렵기 때문이다.
결국 Jenkins가 빌드를 수행한다고 해서 배포 과정 전체의 기준까지 Jenkins가 결정하는 것은 아니었다.
PCMS는 배포 요청과 형상을 관리하고, Jenkins는 그 요청을 실제 빌드 및 배포 작업으로 처리하는 역할이었다.
이 관계를 이해하고 나니 상위 Job이 단순히 여러 Job을 호출하는 용도가 아니라는 것도 알게 됐다.
세 번째 허들, 병렬로 실행하면 정말 빨라질까?
통합 Job에서는 하나의 PCMS 요청으로 여러 애플리케이션을 빌드해야 했다.
상위 Job에서 frontend, backend, PaaS 업무 목록을 분석하고 하위 Job을 병렬로 호출하는 방식이었다.
처음에는 병렬로 실행하면 당연히 빠르고 좋을 거라고 생각했다.
실제로 개별 빌드가 서로 영향을 주지 않는다면 순차 실행보다 효율적이다.
문제는 모든 작업이 생각만큼 독립적이지 않았다는 것이다.
backend에는 공통 모듈인 SHR에 대한 의존성이 있었고, 일부 업무는 해당 모듈이 먼저 준비되어 있어야 정상적으로 빌드할 수 있었다.
그렇다고 모든 작업을 순차적으로 실행하면 병렬화의 의미가 없어진다.
결국 어떤 작업은 먼저 실행되어야 하고, 어떤 작업은 동시에 실행할 수 있는지 구분해야 했다.
여기까지는 그나마 예상할 수 있는 문제였다.
조금 더 황당했던 건 빌드 산출물이었다.
여러 하위 Job이 정상적으로 빌드에 성공했는데, 최종 산출물을 모아둔 디렉터리를 확인하니 일부 업무의 파일만 남아 있었다.
분명 여러 개를 빌드했는데 결과물은 하나다.
처음에는 복사 명령어나 파일 이름이 잘못된 줄 알았다.
확인해 보니 여러 업무의 산출물을 공통 경로로 복사하는 과정에서 파일이 덮어써지거나, 다른 작업이 사용 중인 디렉터리의 파일을 정리하는 문제가 있었다.
각각의 Job은 정상적으로 동작했지만 여러 Job을 동시에 실행하니 예상하지 못한 결과가 나온 것이다.
파일 이름을 변경하거나 복사 방식을 수정하면 당장의 문제는 해결할 수 있었다.
하지만 근본적으로는 서로 다른 빌드가 동일한 디렉터리의 상태를 변경하고 있다는 점이 문제였다.
독립적으로 실행되는 Job이라면 산출물도 독립적으로 관리하는 것이 자연스럽다.
공유 경로에 산출물을 모아야 한다면 각 빌드가 완료된 뒤 별도 단계에서 수집하는 편이 안전할 것이다.
그전까지는 병렬 실행을 단순히 여러 작업을 동시에 실행하는 기능 정도로 생각했다.
이번에는 조금 다르게 느껴졌다.
병렬화하려면 먼저 각각의 작업이 어디까지 독립적인지 확인해야 한다.
서로 영향을 주는 작업을 동시에 실행하면 속도가 빨라지는 게 아니라 문제가 발생하는 속도만 빨라질 수도 있다.
Podman, 이미지 정리도 생각처럼 되지는 않았다
병렬 빌드의 산출물 경로를 확인하는 동안, 컨테이너 플랫폼(PaaS)의 이미지 빌드에서도 살펴볼 일이 있었다.
Jenkins에서 Podman으로 이미지를 만들고 Quay Registry에 Push하는 구조였다. Docker를 사용해 본 경험이 있어서 이미지 빌드 자체는 크게 낯설지 않았다.
그런데 막상 오류가 발생하니 Dockerfile의 각 STEP을 따라가며 어디서 실패했는지부터 확인해야 했다.
COPY 단계에서 파일을 찾지 못하는 경우에는 Jenkins Workspace와 Dockerfile의 위치, 빌드 컨텍스트를 함께 살펴봤다. 서버에 파일이 있어도 빌드 컨텍스트에 포함되어 있어야 가져올 수 있었다.
파일 경로를 확인한 다음에는 각 STEP이 다시 실행됐는지, 기존 캐시를 재사용했는지도 확인했다.
캐시는 빌드 시간을 줄여 주지만, 오류를 추적하는 중에는 어떤 단계까지 새로 실행됐는지 알아야 수정 결과를 판단할 수 있었다.
이 과정에서 기억에 남는 문제는 이미지를 정리할 때 발생했다.
기존 이미지를 지우고 다시 빌드하려고 했는데, 해당 이미지가 어딘가에서 사용 중이라 삭제할 수 없다는 오류가 나왔다.
빌드에 사용했던 이미지니까 지우고 다시 만들면 될 줄 알았다. 그런데 그 이미지를 참조하고 있는 대상이 남아 있었다.
결국 이미지 정리 과정에서 막힌 원인은 사용 중인 이미지에 대한 참조였다. Dockerfile만 들여다봐서는 해결할 수 없는 문제였다.
캐시 재사용 여부를 확인하는 과정에서는 --no-cache 옵션도 실제로 적용했다.
podman build --no-cache -t <이미지명> -f <Dockerfile 경로> <빌드 컨텍스트>이 옵션을 적용해 빌드 캐시를 재사용하지 않고 다시 빌드했다. 사용 중인 이미지를 정리하려면 해당 이미지를 어디서 참조하고 있는지도 별도로 확인해야 했다.
캐시 사용 여부와 이미지 삭제 가능 여부를 각각 확인하고 나서야 어떤 단계에서 문제가 생겼는지 정리할 수 있었다.
이미지 빌드는 Dockerfile의 내용뿐 아니라 실행되는 서버에 남아 있는 이미지와 참조 상태에도 영향을 받고 있었다.
처음에는 빌드 명령 한 줄을 추가하는 작업이라고 생각했는데, 결국 그 명령이 실행되는 환경과 이전 작업의 흔적까지 들여다보고 있었다.
성공한 Job이 정말 성공한 요청일까?
통합 Job에서 또 하나 고민했던 부분은 결과 처리였다.
PCMS에서 여러 업무의 배포를 요청했을 때 일부 하위 Job만 실패하면 어떻게 해야 할까.
전체 요청을 실패로 처리해야 할까? 이미 성공한 업무는 어떻게 관리해야 할까? 다시 실행한다면 실패한 업무만 실행할 수 있을까?
처음에는 SUCCESS와 FAILURE를 취합하면 끝나는 문제라고 생각했다.
하지만 Jenkins의 실행 결과와 실제 배포 요청의 상태는 반드시 일치하지 않았다.
예를 들어 10개 업무 중 9개가 성공하고 1개가 실패했다면 Jenkins 입장에서는 전체 요청을 실패로 처리할 수 있다.
그렇다고 성공한 9개의 결과가 사라지는 것은 아니다.
재실행할 때도 모든 작업을 처음부터 반복할 것인지, 실패한 작업만 수행할 것인지에 따라 고려할 내용이 달라진다.
특히 이미 산출물이 만들어졌거나 일부 배포가 완료된 상태라면 단순 재실행이 또 다른 문제를 만들 수도 있다.
하위 Job을 호출하는 코드는 생각보다 간단했지만, 결과를 어떻게 해석하고 전달해야 하는지는 그렇게 간단하지 않았다.
결국 상위 Job은 여러 작업을 실행하는 것뿐 아니라 개별 작업의 상태를 취합하고, PCMS의 배포 요청에 맞는 결과로 변환하는 역할도 해야 했다.
Jenkins를 빌드 도구로만 생각했을 때는 잘 보이지 않던 부분이었다.
LEVEL 3 > 운영계
네 번째 허들, 배포 버튼의 무게가 달라졌다
개발계와 테스트계를 거쳐 운영계 작업에 들어왔다.
기술적인 흐름 자체는 크게 다르지 않았다.
이미 개발계에서 빌드 환경을 맞췄고, 테스트계에서 통합 Job과 PCMS 연동도 구성했다.
그런데 운영계에서는 같은 작업이라도 신경 쓰이는 부분이 달랐다.
개발계에서는 빌드가 실패하면 로그를 확인하고 수정한 뒤 다시 실행할 수 있었다.
하지만 운영계에서는 실패했을 때 실제 서비스에 어떤 영향을 미치는지까지 고려해야 했다.
물론 운영 배포가 처음부터 무서운 건 아니었다.
정확히는 기존 파이프라인을 분석하면서 점점 무서워졌다.
운영 중인 서비스에 변경 사항을 반영하는 절차에는 생각보다 많은 조건이 붙어 있었다.
배포 대상 서버 그룹, 애플리케이션 유형, 업무 코드, 트래픽 제어, Health Check, 운영계와 DR 구분까지 확인해야 했다.
파이프라인을 실행하는 행위는 같지만, 실패했을 때의 무게는 확실히 달랐다.
홀수와 짝수, 그 사이에 있는 것들
운영계에서는 기존 프로젝트의 홀짝 서버 그룹 배포 방식을 참고했다.
전체 서버를 한 번에 변경하지 않고 홀수와 짝수 그룹으로 나누어 순차적으로 배포하는 구조였다.
처음에는 서버 그룹만 구분해서 배포하면 되는 줄 알았다.
홀수 그룹에 배포하고, 정상 여부를 확인한 다음 짝수 그룹에 배포한다.
말로 설명하면 참 간단하다.
하지만 실제 배포 흐름을 살펴보면 중간에 확인해야 할 조건이 많았다.
언제 트래픽을 차단하고 다시 유입할 것인지, 배포가 끝난 뒤 무엇을 기준으로 정상 상태를 판단할 것인지, 일부 서버에서 문제가 발생하면 다음 단계로 진행해도 되는지 등을 고려해야 했다.
특히 한쪽 그룹에만 신규 버전이 반영된 상태에서 문제가 발생한다면 이전 버전과 신규 버전이 동시에 존재하게 된다.
이때 트래픽을 어느 그룹으로 유지할지, 두 버전이 동시에 실행되어도 문제가 없는지에 따라 대응 방식이 달라진다.
순차적으로 배포한다고 해서 무조건 안전한 것은 아니었다.
운영계 파이프라인에서는 정상적인 실행 순서만큼이나 문제가 발생했을 때 어디서 멈출 것인지가 중요했다.
자동화라고 해서 모든 단계를 끝까지 실행하는 게 좋은 것은 아니다.
차라리 정확한 지점에서 멈추고 사람이 판단할 수 있도록 만드는 편이 안전할 때도 있다.
다섯 번째 허들, 초록색이 항상 성공을 의미하지는 않았다
배포 과정에서도 애플리케이션 유형에 따라 처리 방식이 달랐다.
프로젝트와 backend는 빌드 산출물을 대상 서버 그룹에 전달하는 방식이었고, PaaS는 Podman으로 컨테이너 이미지를 생성해 Quay Registry에 Push하는 구조였다.
PaaS에서는 이미지 생성 이후 Deployment Manifest의 이미지 정보를 변경하고 GitLab에 Push했다.
이후 Jenkins에서 ArgoCD REST API를 호출해 변경된 설정을 동기화하도록 구성했다.
익숙한 GitOps 흐름이다.
그런데 이 과정에서 한 가지 구분해야 할 부분이 있었다.
Jenkins에서 ArgoCD Sync API 호출에 성공했다고 해서 실제 애플리케이션이 정상적으로 실행되고 있다는 뜻은 아니라는 점이다.
이미지가 Registry에 Push된 상태와 Kubernetes에 배포된 상태는 다르다.
Manifest가 변경된 상태와 ArgoCD가 해당 변경을 반영한 상태도 다르다.
심지어 ArgoCD에서 동기화가 완료되더라도 애플리케이션이 정상적인 요청을 처리할 수 있는지는 별도로 확인해야 한다.
Jenkins 콘솔에 성공 메시지가 출력되더라도 실제 서비스 상태까지 보장하는 것은 아니었다.
어쩌면 너무 당연한 이야기일 수도 있다.
하지만 파이프라인 코드를 작성할 때는 특정 명령어의 종료 코드나 API 응답을 기준으로 다음 단계로 넘어가는 경우가 많다.
이 과정에서 내가 확인한 성공이 정확히 무엇의 성공인지 구분해야 했다.
배포 명령이 정상적으로 전달된 것인지, 배포 작업이 완료된 것인지, 실제 서비스가 정상 상태에 도달한 것인지.
모두 다른 이야기였다.
Health Check, 생각보다 단순하지 않았던 정상 판단
배포 이후에는 Health Check를 통해 서비스 상태를 확인해야 했다.
기존 프로젝트에서 사용하던 Health Check 로직을 모바일 웹뱅킹에도 적용하는 과정에서 문제가 발생했다.
모바일 웹뱅킹은 기존 서비스와 사용하는 포트 구성이 달랐고, 이에 맞춰 Health Check 대상 포트 범위를 확장해야 했다.
일부 포트에서는 연결 거부나 타임아웃이 발생했다.
처음에는 단순히 점검할 포트를 추가하면 되는 작업이라고 생각했다.
그런데 확인하다 보니 정상 상태를 무엇으로 판단할 것인지가 더 중요했다.
특정 포트에 연결할 수 있다는 사실과 애플리케이션이 정상적으로 실행되고 있다는 사실은 다르다.
애플리케이션이 실행 중이라고 해서 실제 요청을 정상적으로 처리하고 있다는 보장도 없다.
물론 이번 프로젝트에서 모든 서비스의 기능을 검증하는 수준까지 Health Check를 확장한 것은 아니었다.
기존 운영 체계를 유지하면서 모바일 웹뱅킹의 서비스 구성에 맞게 점검 대상을 조정하는 것이 우선이었다.
다만 다음에 배포 검증 로직을 구성한다면 어떤 상태를 확인해야 배포가 완료되었다고 판단할 수 있을지부터 정리할 것 같다.
Jenkins가 초록색으로 끝나는 것과 서비스가 정상적으로 동작하는 것은 별개의 문제니까.
LEVEL 4 > 기존 운영 환경이라는 제약
여섯 번째 허들, 내 것만 잘 돌아가면 끝나는 게 아니었다
이번 프로젝트에서 계속 신경 써야 했던 부분은 신규 모바일 웹뱅킹만을 위한 독립된 CI/CD 환경이 아니라는 점이었다.
기존 프로젝트 시스템에서 사용하던 CI/CD 서버 2대에 신규 서버 1대를 추가하는 구조였다.
즉, 신규 시스템을 구성하면서 기존 시스템에도 영향을 줄 수 있는 환경이었다.
처음에는 신규 서버를 추가했으니 해당 서버에서만 작업하면 될 거라고 생각했다.
하지만 실제로는 Jenkins Agent Label과 실행 환경, Shared Library, 배포 경로 등 기존 시스템과 공유하는 부분이 많았다.
신규 서버에서 빌드가 잘 된다고 해서 작업이 끝나는 것도 아니었다.
기존 서버에서도 정상적으로 동작해야 했고, 모바일 웹뱅킹을 위한 수정이 프로젝트의 기존 Job에 영향을 주지 않는지도 확인해야 했다.
개발계에서는 잘 돌아가던 파이프라인이 다른 서버에서는 실패하는 경우도 있었다.
앞서 경험했던 Java와 Gradle 버전 문제부터 파일 권한, 실행 경로 차이까지 다시 확인해야 했다.
서버가 한 대 늘어난다고 해서 단순히 빌드할 수 있는 공간만 늘어나는 것은 아니었다.
관리해야 할 실행 환경과 확인해야 할 조건도 함께 늘어났다.
일곱 번째 허들, Agent를 늘리면 빨라질 줄 알았다
빌드 작업을 분산하기 위해 여러 Jenkins Agent를 구성했다.
Agent를 늘리면 동시에 실행할 수 있는 Job도 늘어나니 전체 빌드 시간이 줄어들 거라고 기대했다.
물론 어느 정도는 맞는 이야기다.
문제는 Agent가 늘어난다고 해서 서버의 CPU와 메모리까지 늘어나는 건 아니라는 점이었다.
특히 Podman 이미지 빌드는 CPU와 메모리뿐 아니라 디스크 I/O, 컨테이너 스토리지에도 부하를 준다.
하나의 서버에서 여러 Agent가 동시에 이미지 빌드를 수행하면 서로 영향을 줄 수 있었다.
당연한 이야기지만, 실제로 여러 Job이 동시에 실행되는 환경을 구성하고 나니 조금 다르게 다가왔다.
Jenkins 입장에서는 서로 다른 Agent에서 실행되는 독립적인 작업일 수 있다.
하지만 물리 서버 입장에서는 같은 자원을 사용하는 작업이었다.
결국 빌드 동시성을 제어할 필요가 있었다.
서버별 Lock이나 Queue를 이용해 Podman 이미지 빌드를 순차적으로 실행하는 방안을 검토했다.
여기서도 중요한 건 잠금의 범위였다.
개별 Job 단위로만 잠금을 설정하면 서로 다른 Job이 같은 서버에서 자원을 사용하는 문제는 해결되지 않는다.
실제로 경쟁이 발생하는 자원 단위에 맞춰 동시 실행을 제어해야 했다.
그렇다고 모든 작업을 순차적으로 실행하면 대기 시간이 길어진다.
어떤 작업을 병렬로 실행하고 어떤 작업을 제한할 것인지 판단하려면 실제 서버의 자원 사용량과 빌드 소요 시간을 확인할 필요가 있었다.
이번에는 동시 빌드 제어를 추가 개선 과제로 남겼다.
Agent를 얼마나 많이 구성했는지보다 해당 서버에서 얼마나 안정적으로 작업을 처리할 수 있는지가 더 중요하다는 생각이 들었다.
권한 문제는 생각보다 조심스러웠다
작업 중에는 Jenkins가 배포 경로에 임시 디렉터리를 생성하지 못해 실패하는 문제도 있었다.
처음에는 단순한 파일 권한 오류라고 생각했다.
하지만 확인하다 보니 Jenkins 실행 계정과 배포 디렉터리의 소유자, 그룹 권한까지 함께 살펴봐야 했다.
리눅스에서는 권한 오류가 발생하면 흔히 chmod부터 떠올리게 된다.
물론 권한을 넓히면 당장의 오류는 해결될 수 있다.
하지만 운영 중인 시스템에서 접근 권한을 변경하는 건 단순한 파일 수정이 아니었다.
특정 계정에 권한을 추가했을 때 다른 프로세스에도 영향을 미칠 수 있고, 기존 시스템의 권한 관리 방식과도 맞아야 한다.
특히 금융권 환경에서는 권한을 임의로 변경할 수 있는 상황도 아니었다.
결국 어떤 계정이 어떤 경로에 접근해야 하는지 확인하고, 필요한 범위의 권한을 요청하는 방식으로 진행했다.
간단한 오류 메시지 하나를 해결하는 데에도 확인하고 협의해야 할 부분이 꽤 많았다.
실패하면 한 번 더 실행하면 될까?
기존 파이프라인을 분석하면서 흥미로웠던 부분 중 하나는 특정 Job이 실패했을 때 다시 실행하는 로직이었다.
신규 프로젝트 빌드에서도 실패한 하위 Job을 한 번 더 실행하는 방안을 검토했다.
그런데 생각해 보면 모든 실패가 재실행으로 해결되는 것은 아니다.
Nexus의 일시적인 응답 오류나 네트워크 문제라면 다시 시도하는 것이 의미가 있을 수 있다.
하지만 Java 버전이 맞지 않거나 소스 코드에 문제가 있다면 몇 번을 다시 실행해도 결과는 같다.
오히려 이전 빌드의 Workspace나 산출물이 남아 있는 상태에서 재실행하면 새로운 문제가 발생할 수도 있다.
재실행 기능을 추가하는 것 자체는 어렵지 않았다.
중요한 건 어떤 실패를 재시도할 것인지, 이전 실행의 상태를 어떻게 관리할 것인지, 같은 작업을 다시 실행해도 안전한지였다.
기존 파이프라인에는 이런 방식으로 오랫동안 쌓여 온 예외 처리가 있었다.
처음에는 왜 이렇게 작성했는지 이해하기 어려운 코드도 많았다.
하지만 작업을 진행하면서 특정 코드가 존재하는 이유를 조금씩 이해하게 됐다.
물론 모든 코드에 납득할 만한 이유가 있었던 것은 아니다.
어떤 코드는 당시 문제를 해결하기 위해 추가됐을 것이고, 어떤 코드는 더 이상 필요하지 않을 수도 있다.
다만 그것을 판단하려면 먼저 기존 동작을 충분히 이해해야 했다.
처음 마주했던 숙성된 파이프라인 코드가 조금은 다르게 보이기 시작했다.
LEVEL 5 > 아직 남아 있는 것들
비로소 보이는 이전 작업자의 메시지
이번 프로젝트에서는 기존 운영 환경을 유지하면서 모바일 웹뱅킹의 빌드 및 배포 환경을 구성했다.
개발계의 빌드 환경을 맞추고, 테스트계의 PCMS 기반 통합 Job을 구성했으며, 운영계에서는 기존 배포 절차에 맞춰 신규 애플리케이션을 반영할 수 있도록 작업했다.
GitLab, Nexus, Quay Registry, ArgoCD를 연계하고 여러 Jenkins Agent에서 발생하는 문제도 하나씩 해결했다.
하지만 모든 문제가 깔끔하게 정리된 것은 아니었다.
업무별 산출물을 공유 디렉터리에서 관리하는 방식이나 서버별 빌드 동시성 제어, 일부 Job의 재시도 정책처럼 추가로 개선하고 싶은 부분도 남았다.
당장 동작하도록 만드는 방법과 구조적으로 더 나은 방법이 항상 같지는 않았다.
특히 기존 시스템을 유지해야 하는 상황에서는 새로운 구조를 적용하는 것보다
기존 동작과의 호환성을 확보하는 일이 우선일 때가 많았다.
그렇다고 모든 기존 방식을 그대로 유지하는 것이 정답이라고 생각하지는 않는다.
하지만 이전 작업자는 분명 대단한 사람은 맞는것 같다..
틀린 내용이나 궁금한 점은 댓글로 남겨주세요.